Dos RAG hechos para fallar
Monté dos RAG en n8n para que alumnos de negocio los vieran fallar: trampas a propósito, modelos intercambiables, un eval y el coste de cada respuesta.
· 8 min de lectura
ragn8nevalsdocencia
En septiembre he dado Inteligencia Artificial aplicada a Sectores Productivos, una asignatura de máster en UNIR. Los perfiles son de todos los colores: sobre todo ADE, Derecho y Economía, pero también magisterio e ingeniería, y la mayoría no programa. En dos de las siete sesiones montamos un RAG en n8n: salud el 17 de septiembre e industria el 21.
La guía de clase lo decía en la primera página: lo importante no es que funcione, lo importante es que veas cada pieza y que consigas que falle. El entregable era una captura del fallo más claro que consiguieras.
El objetivo nunca fue que salieran sabiendo montar una prueba de concepto, ni un RAG el día de mañana. Era que, construyendo uno paso a paso y viéndolo a bajo nivel, conocieran el proceso completo: qué herramientas intervienen, por qué está cada una y cómo puede escalar su complejidad. Son perfiles que mañana dirigirán proyectos así, y quiero que lleguen sabiendo qué pueden y qué no pueden hacer estas herramientas, y todo el proceso que hay detrás.
Así que monté los dos para que fallaran, a propósito y en abierto. Aquí va cómo, y qué le diría a una empresa antes de montar uno.
Primero, las trampas
Un RAG trocea tus documentos, convierte cada trozo en una lista de números (un embedding), busca los trozos más parecidos a la pregunta y se los pasa a un modelo para que redacte la respuesta. Sabe qué trozo se parece a la pregunta. No sabe qué documento está vigente.
Los dos corpus están construidos alrededor de ese hueco. NEXORA Salud es un grupo hospitalario ficticio: 984 PDF y 31.088 páginas. Dentro, a propósito, una guía de diabetes tipo 2 de 2008 cuya propia portada avisa de que está pendiente de actualización, al lado de la de tipo 1 de 2026. Y un protocolo interno de 2024 que dice prevalecer sobre las guías externas y fija para el tipo 1 un objetivo de hemoglobina glicada más laxo.
NEXORA Industrial es una planta ficticia: 100 documentos y 6.316 páginas de normativa española y europea, manuales de fabricante y seis documentos internos inventados. Entre sus trampas: una pregunta con cuatro respuestas correctas según el equipo, un reglamento que te manda a otro para la cifra clave, un procedimiento interno más laxo que la ley y normas derogadas conviviendo con las que las sustituyeron.
En la sesión de salud empezamos por lo pequeño: un flujo ya hecho, una clave gratuita de Gemini y dos guías recortadas en un almacén en memoria. Luego, cinco experimentos, como borrar la regla de «responde solo con lo que devuelva la herramienta». La lección salió sola: el RAG usa la guía de 2008 con la misma seguridad que la de 2026.
Qué se puede cambiar y qué no
Un RAG usa dos modelos. El que redacta la respuesta lo cambias cuando quieras, incluso por el de otro proveedor. El de embeddings no se cambia sin volver a indexarlo todo: los vectores de OpenAI (1.536 números por trozo) y los de Gemini (3.072) son mapas distintos, con coordenadas distintas.
El mercado me lo puso fácil. Ollama Cloud no ofrece modelos de embeddings, solo de chat, así que en el montaje completo de salud el modelo de Ollama (gpt-oss:120b) redacta sobre vectores de OpenAI (text-embedding-3-small). Quien redacta y quien convierte el texto en números pueden ser empresas distintas.
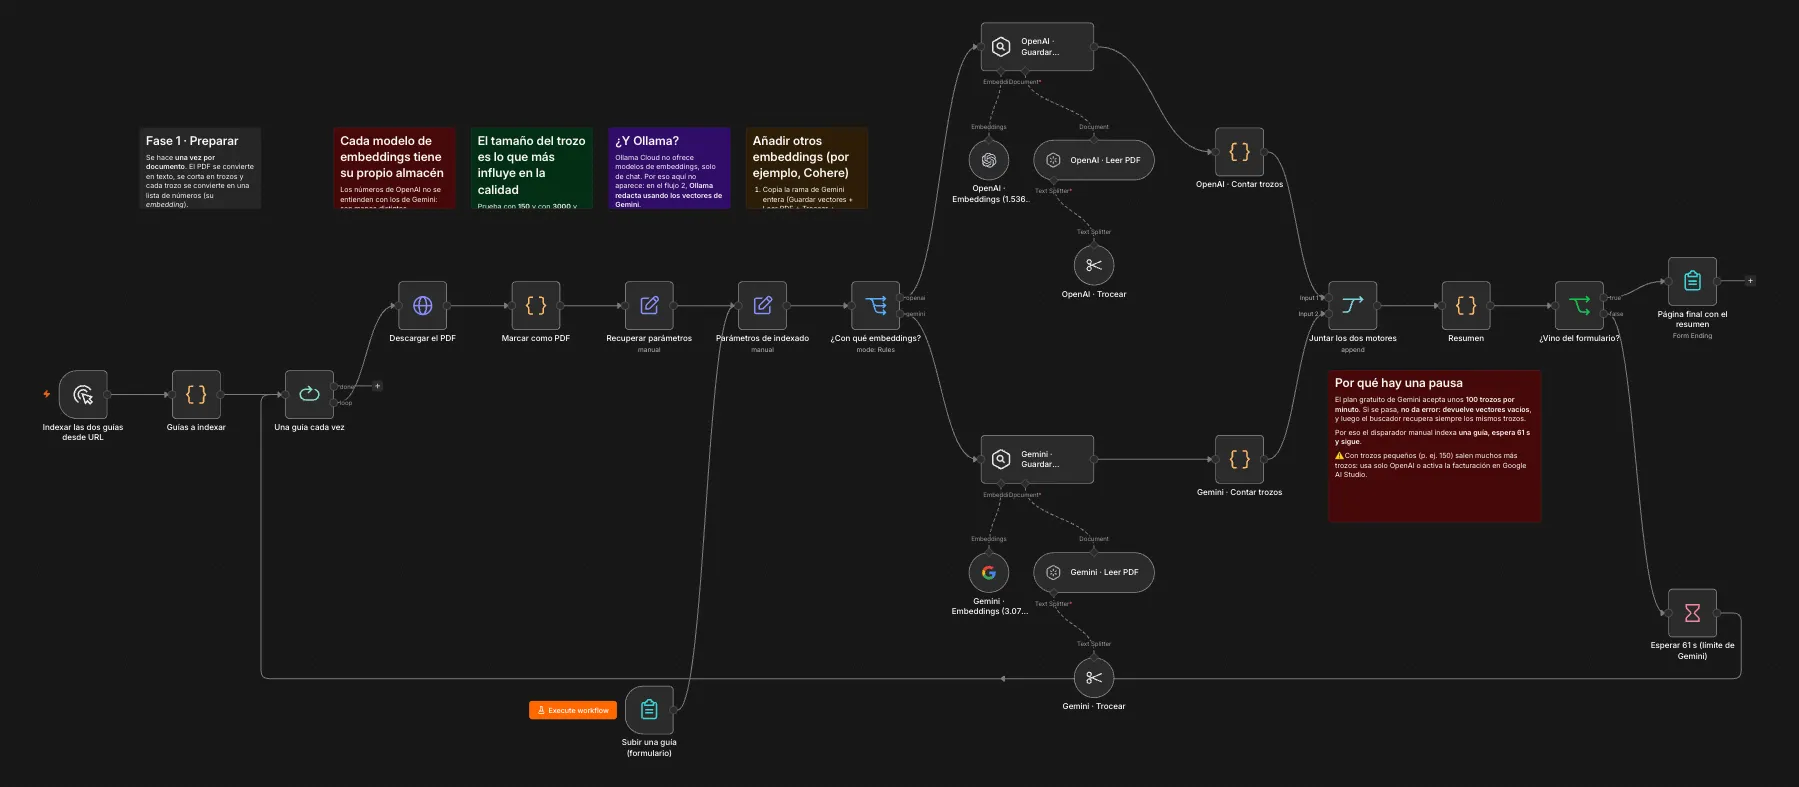
Ese montaje empezó como un encargo por escrito que Claude ejecutó con el servidor MCP de n8n, parando a pedirme el visto bueno entre fases. No salió a la primera: hubo que iterar algún detalle, y con el encargo corregido tras ese primer intento sí salió de una sola vez. El corpus completo acabó en Qdrant Cloud: 128.787 trozos, unos 25 millones de tokens de embeddings (menos de 0,50 $, según la facturación de OpenAI) y 35 minutos, por tandas. La clave gratuita de Gemini se quedó fuera: indexando muchos trozos seguidos, devolvía vectores vacíos sin avisar.
Con el corpus completo encontró un procedimiento interno de dos páginas entre 984 documentos, y dio bien el rango de hemoglobina glicada de la guía de 2026 para el tipo 1 sin mencionar el protocolo interno, que dice otra cosa. Recuperar bien no es lo mismo que detectar contradicciones.
Una pregunta, tres respuestas
El corpus industrial acabó en 24.662 trozos en Qdrant, cada uno con 10 etiquetas. Eso lo hace agéntico: una sola colección, tres herramientas de búsqueda filtradas por tipo de documento (norma, interno, manual) y un agente que elige cuál usar leyendo la descripción de cada una. Tres perfiles de chat, que se eligen con un prefijo, comparten esa colección y sus embeddings; solo cambia quién redacta y con cuánto contexto.
Y entonces pregunté cada cuánto se retimbra un extintor. El reglamento de protección contra incendios no lo dice: remite al de equipos a presión. El vigente no está en el corpus. El que sí está, de 2008, lleva derogado desde el 2 de enero de 2022, y lo dice su propio texto.
/rapido (gpt-4o-mini, 4 trozos) se inventó «cada 10 años» y lo atribuyó a una página que solo contiene un listado de normas UNE.
/potente (gpt-5.6-luna, 10 trozos) encontró la cifra real, cada cinco años, sin avisar de que sale de un reglamento derogado. Y no es culpa del prompt: el aviso de derogación está en la página 7 del PDF y la cifra, en la 30. Son trozos distintos. Nunca viajan juntos.
/ollama (deepseek-v4-pro:cloud, 10 trozos) unas veces encontró la remisión literal y dijo que el reglamento al que apunta no está cargado. Otras veces dio la cifra del derogado.
Esa fue la lección que no había preparado: misma pregunta, mismo perfil, mismo corpus, y no siempre la misma respuesta. Depende de qué trozos devuelva la búsqueda. ¿Firmarías un informe de cumplimiento con esto? Ninguna regla del mensaje de sistema arregla el troceado. Lo arreglaría etiquetar la vigencia de cada norma al indexar.
33 de 35, y por qué la nota no es lo importante
«Lo he probado un rato y va bien» no es una respuesta. Por eso el montaje industrial tiene un eval: siete casos fijos, cada uno con su criterio escrito, que se pasan siempre igual.
Juzga en dos capas. Primero, las comprobaciones automáticas: ¿cita el reglamento de incendios?, ¿NO aparece «10 años»? Son gratis, instantáneas y siempre dan lo mismo. Al juez con modelo solo le queda lo que de verdad pide criterio, como si la respuesta distingue quién hace cada revisión.
{
  pregunta: '¿Cada cuánto se retimbra un extintor?',
  debe_citar_doc: [7],                             // automática: el reglamento de incendios
  no_debe_contener: ['10 a(n|ñ)os|diez a(n|ñ)os'], // automática: la cifra inventada
  criterio: 'Evalua UNICAMENTE lo que la respuesta dice sobre el RETIMBRADO o timbrado…', // juez con modelo
}
En clase pasamos los siete casos cinco veces cada uno: 33 aciertos de 35 (94%), por unos cuatro céntimos. La pregunta del retimbrado acertó tres veces de cinco. Tres cosas importaron más que la nota.
Un criterio laxo da un verde falso. La primera versión daba un 100% porque un criterio aceptaba «menciona la remisión o avisa de la derogación». Citar el reglamento derogado sin avisar pasaba. Separado en dos casos, el 100% se cayó. Tu criterio es tu especificación.
El juez también se equivoca. Un caso sacó 0 de 2 con respuestas correctas: el juez leía «mantenimiento trimestral» como si fuera un plazo de retimbrado. Acotando el criterio al retimbrado, pasó a 3 de 3.
Un caso inestable es peor que uno que falla siempre. El que falla siempre lo ves y lo arreglas. El inestable pasa tus pruebas el día que lo revisas y te explota en producción un martes cualquiera. Por eso el flujo repite cada caso y saca la lista de los inestables.
Cuánto cuesta una respuesta
La misma pregunta, medida en el sistema real (precios comprobados el 19 de septiembre):
| Perfil | Modelo | Por millón de tokens (entrada / salida) | Coste de la respuesta |
|---|---|---|---|
/ollama |
deepseek-v4-pro:cloud | 0,022 $ / 1,98 $ | 0,0011 € |
/rapido |
gpt-4o-mini | 0,15 $ / 0,60 $ | 0,0014 € |
/potente |
gpt-5.6-luna | 0,20 $ / 1,20 $ | 0,0075 € |
DeepSeek tiene la salida más cara de los tres y aun así da la respuesta más barata, porque en un RAG manda la entrada: en cada pregunta le metes varios trozos. Y el perfil más barato no lo hizo peor en la pregunta difícil, lo que ya rompe la intuición de que pagar más da mejor resultado.
Lo que más cuesta no sale en ninguna factura: mantener los documentos al día, medir la calidad y revisar lo que responde.
Antes de que una empresa monte uno
Todas las prácticas que doy son prototipos, y lo digo en voz alta: el salto a producción es una competencia de consultoría, no un detalle técnico. Los chats públicos no tenían contraseña y gastaban mis créditos, así que ahora están apagados, a propósito.
Una versión para un hospital o una planta necesitaría control de acceso, límites de uso, metadatos de vigencia, documentos que se actualicen cuando cambia una norma, evaluación sistemática, trazabilidad y una persona que responda de lo que dice.
A una empresa le haría las preguntas con las que dejé a mis alumnos. ¿Cuál es tu «guía de 2008», el documento caducado que tu RAG usará con la misma seguridad que el vigente? ¿Qué dos documentos tuyos se contradicen sin que nadie lo haya mirado? ¿Cuál remite a otro que no tienes?
Ninguna se arregla con un modelo mejor. Se arreglan eligiendo, fechando, etiquetando y retirando documentos, y eso es trabajo de personas.
Los dos repositorios son públicos, con el inventario del corpus, los flujos de n8n y lo que falló por el camino. Los scripts y los documentos ficticios van con licencia CC0. Las guías de clase están en la página de IASP.